
27 KiB
长期记忆
长期记忆 让 QwenPaw 拥有跨对话的持久记忆能力。默认后端会在 QwenPaw 进程内嵌入 ReMe 应用,并通过 ReMe jobs 完成对话事实保存、每日记忆、梦境摘要、资源文件监听和记忆检索。
长期记忆机制设计受 OpenClaw 启发,由 ReMe 的 ReMeLight 实现——以文件系统为存储后端,工作记忆与长期记忆节点均为 Markdown 文件,可直接读取、编辑与迁移。
ReMe 的核心目标,是基于 Memory as File, File as Memory 原则长出一个自进化的个人知识库。每个工作记忆或长期记忆节点都是一份普通 Markdown 文件——可读、可编辑、可追溯、可迁移、由你与 agent 协作维护——同时又可被索引和链接;原始来源与派生系统状态则使用适合各自职责的格式。workspace 把记忆组织为四层:
| 分层 | QwenPaw 目录 | 职责 |
|---|---|---|
| 原始输入 | mem_session/、resource/ |
作为证据保留的原始对话与外部资料 |
| 工作记忆 | memory/ |
daily note:事实、决策、资源解读 |
| 长期记忆 | digest/ |
可复用知识节点(personal / procedure / wiki) |
| 系统状态 | mem_metadata/ |
索引、wikilink 图、catalog——不手工编辑 |
记忆通过 capture → index → consolidate → recall 闭环进化:Auto-Memory / Auto-Resource 捕获 daily note,索引让其可检索,Auto-Dream 把它们整合成带链接的 digest 节点,search / proactive 再召回。完整叙述——包括 Auto-Dream 如何对 digest 节点 corroborate、refine、correct 并织成 wikilink 图——见智能体记忆进化与主动交互。以下章节聚焦技术实现与配置。
架构概览
graph TB
    User[用户 / Agent] --> Middleware[MemoryMiddleware]
    Middleware --> Manager[ReMeLightMemoryManager]
    Manager --> ReMe[嵌入式 ReMe 应用]
    ReMe --> Jobs[ReMe Jobs]
    Jobs --> AutoMemory[auto_memory]
    Jobs --> AutoDream[auto_dream]
    Jobs --> Search[search]
    Jobs --> Resource[auto_resource]
    Jobs --> Reindex[reindex / index_update_loop]
    AutoMemory --> Daily[memory/YYYY-MM-DD/*.md]
    AutoMemory --> Session[mem_session/dialog/*.jsonl]
    AutoDream --> Digest[digest/*.md 和 interests.yaml]
    Resource --> ResourceDir[resource/*]
    Search --> Store[mem_metadata 文件存储 + BM25 + 可选向量]
长期记忆管理包含以下能力:
| 能力 | 说明 |
|---|---|
| 嵌入式 ReMe | QwenPaw 在进程内启动 ReMe,并将当前 Agent 使用的 QwenPaw 模型注入到 ReMe 默认 LLM 组件 |
| Auto-Memory | 每隔可配置数量的用户回合,将对话中值得保留的事实抽取为每日 Markdown 记忆 |
| 上下文压缩保存 | 上下文压缩前,可把尚未写入的回合先提交给同一套 auto_memory 流程 |
| Auto-Dream | 定时从近期每日记忆中提取更高层的 digest 单元和主动交互兴趣主题 |
| 混合检索 | memory_search 调用 ReMe search job,通过 BM25 + 可选向量检索,并使用 RRF 融合排序 |
| 资源记忆 | resource/ 下的外部文件会被编目,变更后可通过 auto_resource 转成带来源链接的每日记忆 |
| Inbox 通知 | auto_memory、auto_dream、auto_resource 产生结果时,会推送到 QwenPaw inbox |
记忆文件结构
记忆以普通文件保存在 Agent 工作区中。ReMe 写出的 Markdown 是可读的记忆源数据,mem_metadata/ 则保存搜索索引、catalog、graph
和 embedding cache 等持久状态。
{工作区}/
├── memory/                         ← 每日记忆
│   └── 2026-06-29/
│       ├── project-plan.md          ← auto_memory 创建或更新的单条记忆
│       └── index.md                 ← 当日记忆索引
│
├── mem_session/
│   └── dialog/
│       └── <session_id>.jsonl       ← 作为记忆来源的对话记录
│
├── digest/                         ← Auto-Dream 产出的 digest 记忆和兴趣主题
├── resource/                       ← auto_resource 监听的外部资源
└── mem_metadata/                   ← ReMe 持久化索引、图、catalog 和缓存
    ├── file_store/
    │   └── file_chunks_default_v1.jsonl.zst
    ├── file_graph/
    │   └── default.jsonl.zst
    ├── file_catalog/
    │   ├── default.jsonl.zst
    │   ├── resource.jsonl.zst
    │   ├── digest.jsonl.zst
    │   └── dream.jsonl.zst
    ├── embedding_store/
    │   └── default_v1.npz
    └── keyword_index/
        └── bm25_default_<tokenizer>_<fingerprint>_v1.pkl
默认工作区下的完整路径是
~/.qwenpaw/workspaces/{agent_id}/mem_metadata/。其中
file_store/file_chunks_default_v1.jsonl.zst 是权威 chunk 存储,向量以 float16
编码在压缩 JSONL 记录的 _embedding_f16_b64 字段中,并不会生成单独的向量数据库目录。
embedding_store/default_v1.npz 是启用 enable_cache 后使用的本地 embedding
缓存,不是权威索引;它可能要到缓存持久化后才出现。实际 BM25 文件名中的 tokenizer
名称和 fingerprint 会随配置变化。
memory/YYYY-MM-DD/*.md(每日记忆)
每日记忆是 Auto-Memory 的默认输出。ReMe 每天会写入一到多条记忆,并通过来源会话来定位已有记忆,后续同一会话的新内容会更新既有 note,而不是无限创建重复文件。
- 位置:
{working_dir}/memory/YYYY-MM-DD/*.md - 用途:保存长期有用的对话事实、决策、偏好和工作记录
- 更新:ReMe
auto_memory通过daily_write、read、edit、frontmatter_update、write等 ReMe 文件 jobs 创建或编辑 - 索引:每次成功写入后,ReMe 会刷新当天的
index.md
mem_session/dialog/*.jsonl(来源对话)
抽取记忆前,ReMe 会把相关消息保存为 session log。保存时会去掉 tool result 和 base64 数据块,避免未来的 Auto-Memory 把“检索出来的旧记忆”或大媒体内容误当成用户新提供的事实。
- 位置:默认
{working_dir}/mem_session/dialog/<session_id>.jsonl - 用途:为每日记忆提供可追溯的来源
- 链接:每日记忆 frontmatter 会通过
[[mem_session/dialog/<session_id>.jsonl]]链接回来源会话
digest/(梦境记忆)
digest/ 是长期知识层,也是知识库真正进化的部分。Auto-Dream 读取近期每日记忆,提取可复用的 memory unit,把每个 unit
整合进一个 digest 节点,更新 dream catalog,并写入主动交互使用的兴趣主题。
- 位置:
{working_dir}/digest/ - Bucket:
personal/(用户、团队、项目身份、偏好与约定)、procedure/(how-to 工作流、runbook、可复用方法)、wiki/(定义、原则、观察、作为先例的决策) - 进化而非追加:每个 unit 以
CREATE、CORROBORATE、REFINE、CORRECT之一整合,重复事实会被合并强化而非制造副本 - Wikilink 图:节点带有来源边(
derived_from:: [[memory/<date>/<note>.md]])与关系边 (relates_to:: [[digest/...]]),让 digest 记忆保持可追溯、可连通;memory_search会沿这些链接展开 - 更新:ReMe
auto_dream,通常由dream_cron定时触发
resource/(资源记忆)
resource/ 下的文件会被监听和编目。支持的文件发生变化时,ReMe 可以通过 auto_resource 将其解释为带来源链接的每日记忆。
- 位置:
{working_dir}/resource/ - 默认支持后缀:
md、txt、json、jsonl、csv、yaml、html - 日期归属:直接放在
resource/下的文件归入当天;resource/YYYY-MM-DD/下的文件归入指定日期,且可继续使用子目录 - 输出:生成或更新
memory/YYYY-MM-DD/<note>.md,frontmatter 中保留source_resource链接 - Inbox 行为:只有实际修改记忆时,资源处理结果才会推送到 inbox
resource/report.txt                    # 归入当天
resource/2026-07-14/report.txt         # 归入 2026-07-14
resource/2026-07-14/project/data.json  # 日期目录下可使用子目录
Auto Resource 当前按 UTF-8 文本读取资源。PDF、Word、Excel、图片等二进制文件不在监听后缀中, 不会被自动解析;请先转换为上述受支持的文本格式。
yml也不在默认白名单中,请使用yaml。
关于 Auto-Memory、Auto-Dream、Auto-Memory-Search 和 Proactive 的完整工作流介绍,请参阅 智能体记忆进化与主动交互。以下仅补充技术实现细节与配置说明。
搜索记忆
Agent 有两种方式找回过去的记忆:
| 方式 | 工具 | 适用场景 | 示例 |
|---|---|---|---|
| 混合检索 | memory_search |
不确定记在哪个文件,按意图模糊召回 | "之前关于部署流程的讨论" |
| 直接读取 | 文件工具 | 已知具体日期或文件路径,精确查阅 | 读取 memory/2026-06-29/project-plan.md |
混合检索原理
memory_search 会调用 ReMe 的 search job。搜索始终尝试 BM25 关键词检索;当配置了 embedding 模型时,也会同时运行向量检索。
两路都有结果时,ReMe 使用 Reciprocal Rank Fusion(RRF) 融合排序。
向量语义搜索
将文本映射到高维向量空间,通过余弦相似度衡量语义距离,能捕捉意义相近但措辞不同的内容:
| 查询 | 能召回的记忆 | 为什么能命中 |
|---|---|---|
| "项目的数据库选型" | "最终决定用 PostgreSQL 替换 MySQL" | 语义相关:都在讨论数据库技术选择 |
| "怎么减少不必要的重建" | "配置了增量编译避免全量构建" | 语义等价:减少重建 ≈ 增量编译 |
| "上次讨论的性能问题" | "P99 延迟从 800ms 优化到 200ms" | 语义关联:性能问题 ≈ 延迟优化 |
但向量搜索对精确、高信号的 token 表现较弱,因为嵌入模型倾向于捕捉整体语义而非单个 token 的精确匹配。
BM25 关键词检索
基于词频统计进行子串匹配,对精确 token 命中效果极佳,但在语义理解(同义词、改写)方面较弱。
| 查询 | BM25 能命中 | BM25 会漏掉 |
|---|---|---|
handleWebSocketReconnect |
包含该函数名的记忆片段 | "WebSocket 断线重连的处理逻辑" |
ECONNREFUSED |
包含该错误码的日志记录 | "数据库连接被拒绝" |
ReMe 会为被索引文件维护本地 BM25 索引。它适合命中精确标识符、错误码、文件名和低频词;即使没有配置 embedding,也能提供关键词召回。
混合检索融合
当向量检索和 BM25 都返回候选时,ReMe 使用加权 RRF 融合。默认向量权重为 0.7,剩余 0.3 给关键词检索。
- 扩大候选池:将最终需要的结果数乘以
candidate_multiplier(默认 3 倍,上限 200),两路分别检索更多候选 - 独立排序:向量和 BM25 各自返回排序后的候选列表
- RRF 合并:按 chunk id 去重,并叠加基于排名的贡献:
- 向量贡献:
0.7 / (60 + vector_rank) - 关键词贡献:
0.3 / (60 + keyword_rank) - 两路都命中的 chunk 会获得两份贡献
- 向量贡献:
- 排序截断:按
final_score降序排列,返回 top-N 结果 - 链接展开:搜索结果可附带相关链接文件上下文,帮助理解命中片段
示例:查询 "handleWebSocketReconnect 断线重连"
| 记忆片段 | 向量排序 | BM25 排序 | 排名靠前原因 |
|---|---|---|---|
| "handleWebSocketReconnect 函数负责 WebSocket 断线重连" | 2 | 1 | 语义匹配强,同时精确命中关键词 |
| "网络断开后自动重试连接的逻辑" | 1 | - | 语义匹配强,即使没有精确函数名也能召回 |
| "修复了 handleWebSocketReconnect 的空指针异常" | - | 2 | 精确标识符命中,使其保留在候选集中 |
graph LR
    Query[搜索查询] --> Vector[向量语义搜索 x0.7]
    Query --> BM25[BM25 关键词检索 x0.3]
    Vector --> Merge[按 chunk 去重 + 加权 RRF]
    BM25 --> Merge
    Merge --> Sort[按融合分数降序排列]
    Sort --> Results[返回 top-N 结果]
总结:单独使用任何一种检索方式都存在盲区。混合检索让两种信号互补,无论是「自然语言提问」还是「精确查找」,都能获得可靠的召回结果。
验证向量检索是否生效
可以让 Agent 调用 memory_search 并原样返回工具结果。把 xxx 替换成要测试的查询:
请调用 memory_search 工具搜索 "xxx"。请原样返回工具结果,包括所有分隔线以及
score、vector、keyword 字段,不要总结或改写。
若要验证语义召回而不是关键词匹配,可以先保存一条记忆,例如 “我首选的通勤工具是一辆轻便自行车。”,再搜索“用户平时怎样去上班?”。两句话没有明显的关键词重合, 但语义相近,因此更容易观察向量检索是否命中。
下面的分数仅用于说明输出格式:
仅向量分支命中:
========== memory/2026-07-23/commute.md:1-6 [score=0.8237] ==========
我首选的通勤工具是一辆轻便自行车。
此时 score 是原始余弦相似度。
仅 BM25 分支命中:
========== memory/2026-07-23/commute.md:1-6 [score=3.1842] ==========
我首选的通勤工具是一辆轻便自行车。
此时 score 是原始 BM25 分数。只有 [score=...] 时,单看数值不能严格判断是哪一路;
应结合查询是否存在精确关键词,或者查看下面的检索日志。
两路均有候选的混合检索:
========== memory/2026-07-23/commute.md:1-6 [score=0.0164 vector=0.8237 keyword=3.1842] ==========
我首选的通勤工具是一辆轻便自行车。

========== memory/2026-07-20/purchase.md:3-7 [score=0.0113 vector=0.7915 keyword=-] ==========
用户买了一辆轻便的两轮交通工具。

========== memory/2026-07-18/maintenance.md:2-5 [score=0.0048 vector=- keyword=2.5176] ==========
周末安排了自行车维护。
score:RRF 融合分数vector:原始向量余弦相似度;出现数值可直接确认向量分支返回了该结果keyword:原始 BM25 分数-:该结果没有被对应分支召回
日志中的 vector_hits=N keyword_hits=M 可以确认每一路返回的候选数量。Embedding
健康检查还会发送一次 "ping" 测试请求,并校验返回向量维度:
[EMBEDDING HEALTH CHECK] name=default workspace_dir=<workspace> -> OK
-> OK 表示 embedding 服务可访问且返回维度与配置一致。失败时日志会包含原因,例如:
[EMBEDDING HEALTH CHECK] name=default workspace_dir=<workspace> -> FAIL timeout(5.0s)
[EMBEDDING HEALTH CHECK] name=default workspace_dir=<workspace> -> FAIL RuntimeError: embedding dimension mismatch: <actual> != <configured>
[EMBEDDING HEALTH CHECK] name=default workspace_dir=<workspace> -> FAIL <ExceptionType>: <message>
健康检查会在加载持久化 chunk、发现缺失向量并需要 backfill 时运行;如果已有 chunk
都包含有效向量,它不一定在每次启动时出现。此时搜索结果中的数值 vector=...
仍是向量分支实际命中的直接证据。
记忆配置
配置结构
记忆配置位于 agent.json 的 running.reme_light_memory_config 中:
| 配置项 | 说明 | 默认值 |
|---|---|---|
metadata_dir |
ReMe 持久状态目录,用于保存索引、catalog、graph 和缓存 | "mem_metadata" |
session_dir |
来源对话保存目录 | "mem_session" |
mem_session_dir |
ReMe 内部 memory-agent 会话目录 | "mem_agent" |
resource_dir |
auto_resource 监听的资源目录 |
"resource" |
daily_dir |
每日记忆目录 | "memory" |
digest_dir |
dream/digest 记忆目录 | "digest" |
summarize_when_compact |
是否在上下文压缩前将待保存回合提交给 Auto-Memory | true |
inbox_push_enabled |
是否将 auto_memory、auto_dream、auto_resource 的 job 结果推送到 QwenPaw inbox |
true |
auto_memory_interval |
每隔 N 个用户回合触发 Auto-Memory。None 或 <= 0 表示禁用周期自动记忆 |
5 |
dream_cron_enabled |
是否启用按 Cron 定时执行的 Auto-Dream 任务 | true |
dream_cron |
Auto-Dream 任务的有效 5 段 Cron 表达式(启用时必填);触发后随机延迟 0–60 秒启动 | "0 23 * * *" |
重建记忆搜索索引
重建索引是一项显式维护操作,仅建议用于修复索引损坏或搜索结果异常。该操作会清空并重新创建 ReMe 搜索索引, 执行期间 CPU 和内存占用可能明显升高。只有使用 ReMeLight 记忆后端且记忆管理器正在运行的智能体支持此操作。
在控制台中,打开智能体配置,在长期记忆区域选择重建记忆索引,阅读警告后确认执行。也可以调用以下 同步维护 API:
POST /api/agents/{agentId}/memory/reindex
重建成功时返回 {"status":"completed"}。同一智能体同时只能执行一个重建任务;重复请求会返回 HTTP 409。
非 ReMeLight 后端会返回 400,智能体不存在时返回 404,ReMe 不可用时返回 503,重建任务失败时返回 500。
rebuild_memory_index_on_start已不再支持,请从agent.json中删除该字段;确实需要重建索引时,请改用 控制台操作或上述 API。
自动记忆搜索配置
在 running.reme_light_memory_config.auto_memory_search_config 中配置:
启用后,搜索结果会作为已完成的 memory_search 交互注入当前 live context。
同一轮工具循环里的后续模型调用仍可读取这些结果,直到常规上下文管理将其驱逐。
| 配置项 | 说明 | 默认值 |
|---|---|---|
enabled |
是否在每次对话时自动执行记忆搜索 | false |
max_results |
自动搜索时最多返回的结果数 | 2 |
Embedding 配置(可选)
Embedding 配置用于向量语义搜索,位于 running.reme_light_memory_config.embedding_model_config:
| 配置项 | 说明 | 默认值 |
|---|---|---|
backend |
Embedding 后端类型:openai、dashscope、dashscope_multimodal、gemini、ollama |
openai |
api_key |
Embedding 服务的 API Key。OpenAI 兼容和 Gemini 后端必填 | `` |
base_url |
OpenAI 兼容后端的可选自定义 API 地址;Ollama 后端会作为 host 传递 | `` |
model_name |
Embedding 模型名称 | `` |
dimensions |
Embedding 向量维度 | 1024 |
enable_cache |
是否启用 Embedding 缓存 | true |
use_dimensions |
是否在 API 请求中传递 dimensions 参数 | false |
max_cache_size |
Embedding 缓存最大条目数 | 10000 |
max_input_length |
单次 Embedding 的近似字符预算 | 8192 |
max_batch_size |
Embedding 批处理最大数量 | 10 |
use_dimensions用于某些 vLLM 模型不支持 dimensions 参数的情况,设为false可跳过该参数。
从 ReMe 0.4.1.0 开始,Embedding 输入截断会为 token 密度更高的 CJK 和其他全角字符采用更保守的预算,
并预留安全余量。这可以避免较长的中文记忆在 Ollama + bge-m3 等组合下超过模型上下文窗口并返回 HTTP 400。
max_input_length 仍是近似字符预算,并非模型 tokenizer 计算出的严格 token 上限;如果所用模型的上下文窗口更小,
仍应相应调低该值。
向量检索只有在当前后端具备最低可运行配置时才会启用;这些条件与 AgentScope credential 要求保持一致:
| 后端 | 启用条件 | Credential 映射 |
|---|---|---|
openai / dashscope / dashscope_multimodal |
model_name 和 api_key 均非空 |
api_key;可选 base_url |
gemini |
model_name 和 api_key 均非空 |
api_key |
ollama |
model_name 非空 |
可选 host(来自 base_url) |
索引行为
嵌入式 ReMe 配置使用本地 file store:
| 组件 | 行为 |
|---|---|
| File store | ReMe 本地文件存储,持久状态位于 mem_metadata/ |
| 关键词索引 | 默认启用 BM25 关键词索引 |
| 向量索引 | 仅当 embedding_model_config 满足当前 backend 的启用条件时启用 |
| 监听目录 | daily_dir 和 digest_dir |
| 监听后缀 | md |
其他 Memory Backend
QwenPaw 的记忆系统采用可插拔的 Backend 架构。除了默认的 ReMeLight(本地文件存储)外,还支持通过 memory_manager_backend 切换到其他后端。
ADBPG(AnalyticDB for PostgreSQL)
基于云端向量数据库的长期记忆后端,适合需要跨设备共享、大规模语义检索的场景。QwenPaw 通过 ADBPG 记忆服务的 REST API 接入,无需安装额外数据库驱动。
核心特点:
- 跨会话持久化 — 记忆存储在云端数据库,重启后不丢失,支持多设备共享
- 服务端事实抽取 — 由 ADBPG 记忆服务完成事实提取,客户端无额外开销
- REST API 接入 — 通过 HTTP API 调用 ADBPG 记忆服务
- 优雅降级 — ADBPG 不可达时 Agent 正常运行,仅长期记忆功能暂时禁用
配置方式:
进入 Agent 配置页面的「运行配置」标签,找到「长期记忆管理后端」下拉框,选择 adbpg,并在「ADBPG 长期记忆」Tab 中填写 REST Base URL 与 REST API Key。
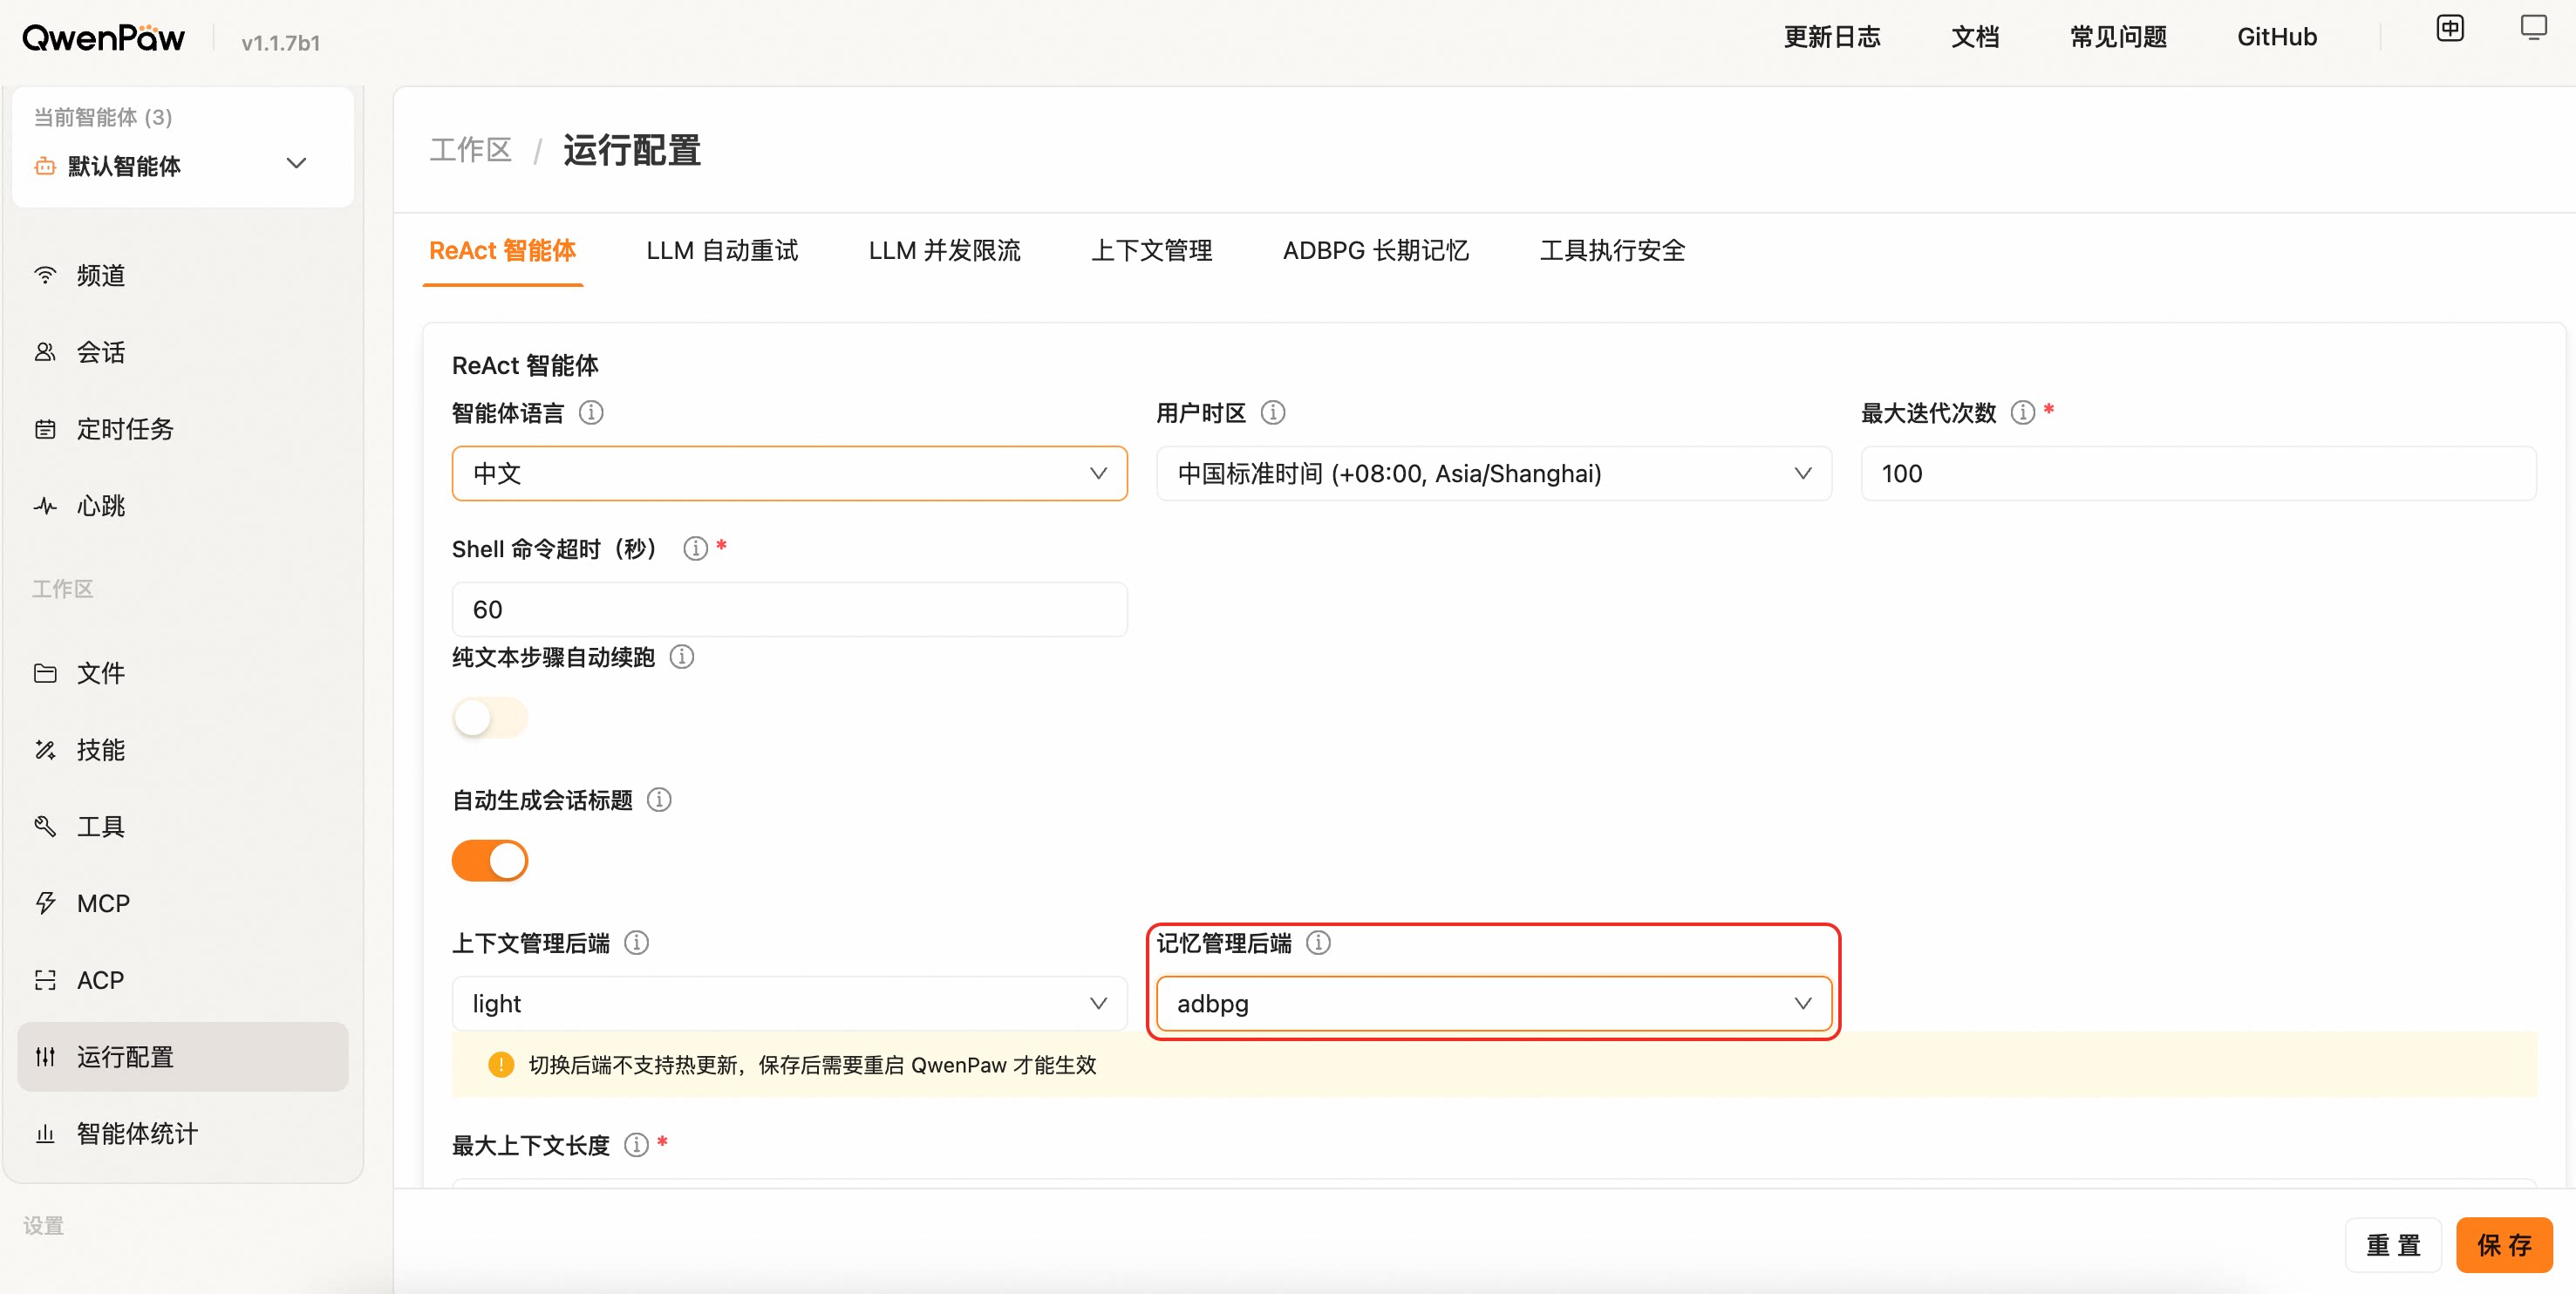
⚠️ 切换后端不支持热更新,保存后需要重启 QwenPaw 才能生效(页面也会以黄色横幅提醒)。
迁移提示:ADBPG SQL 直连模式已移除。旧配置中的
api_mode: "sql"、host、port、user、password、dbname、LLM 和 Embedding 相关字段 会被忽略;请改为配置rest_base_url和rest_api_key,保存后重启 QwenPaw。
| 配置项 | 说明 | 默认值 |
|---|---|---|
rest_base_url |
ADBPG 记忆服务的 REST API 地址 | "" |
rest_api_key |
REST API 的访问密钥 | "" |
memory_isolation |
记忆隔离模式,true 为每个 Agent 独立,false 为共享 |
true |
search_timeout |
记忆搜索超时时间(秒) | 10.0 |
auto_memory_search_config |
自动记忆搜索配置,结构与 ReMe Light 的 auto_memory_search_config 一致 |
{"enabled": true, "max_results": 3} |
配置示例:
完整配置可写入 agent.json 的 running.adbpg_memory_config 字段:
{
  "running": {
    "memory_manager_backend": "adbpg",
    "adbpg_memory_config": {
      "rest_base_url": "https://your-adbpg-memory-api.example.com",
      "rest_api_key": "your-rest-api-key",
      "memory_isolation": true,
      "search_timeout": 10.0,
      "auto_memory_search_config": {
        "enabled": true,
        "max_results": 3
      }
    }
  }
}
💡 通过 Console「运行配置」页面填写时,框架会自动将这些字段写入
agent.json,无需手动编辑文件。